Treinando na GPU do Mac a partir do Kubeflow Pipelines com o KubeSilicon
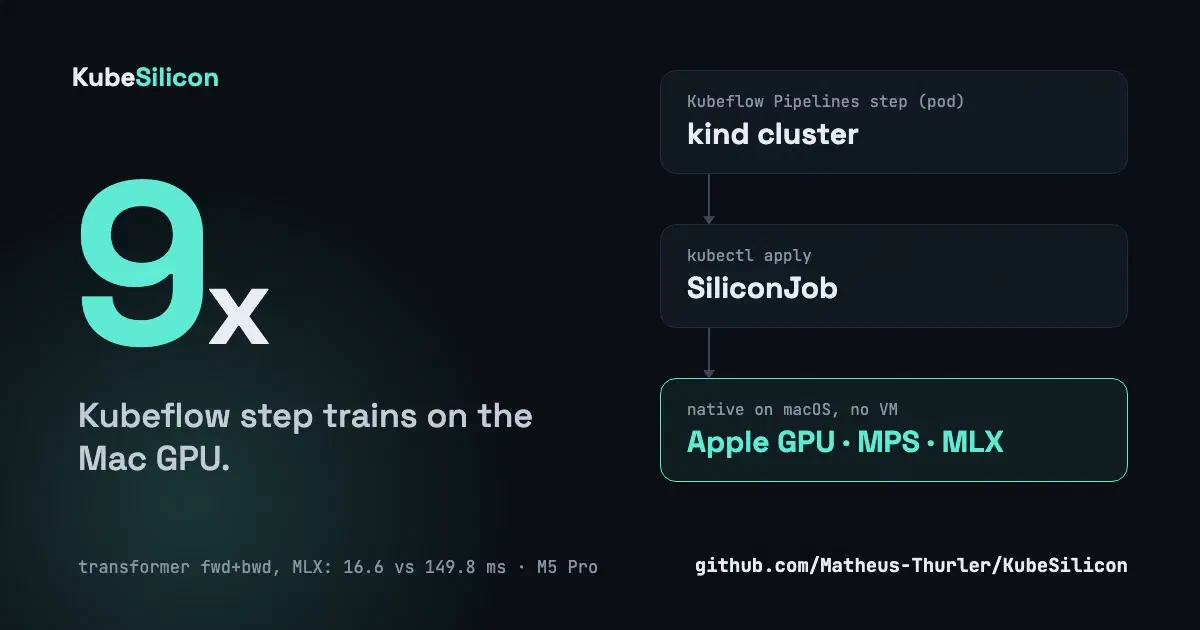
No post anterior eu criei o KubeSilicon para rodar VMs Linux em um Mac a partir de objetos do Kubernetes. A pergunta óbvia que vem depois é: a VM consegue usar a GPU do Mac?
Não. Um guest Linux no Virtualization.framework da Apple não tem caminho até o Metal. É um limite da plataforma, não um bug que eu possa corrigir.
Então parei de tentar colocar a GPU dentro da VM e levei o trabalho para onde a GPU está.
A ideia: rodar nativo e pedir pelo Kubernetes
Um SiliconJob é um objeto do Kubernetes. O daemon que já roda no Mac observa o objeto, cria um ambiente Python isolado com uv, instala as dependências e roda o script no macOS com PyTorch MPS ou MLX.
apiVersion: kubesilicon.io/v1
kind: SiliconJob
metadata: { name: mlx-matmul }
spec:
  dependencies: [mlx]
  script: |
    import mlx.core as mx
    print(mx.default_device())   # Device(gpu, 0)
A fase e os últimos 4 KiB do log são copiados para o status, então kubectl get sjob -w funciona como você espera. Entradas e saídas são URLs HTTP comuns (URLs pré-assinadas funcionam), e o job nunca vê credenciais.
Como o Kubeflow enxerga isso
Ele não enxerga, e esse é o ponto. Não existe plugin do Kubeflow. Um passo do pipeline é um pod, o pod cria um SiliconJob pela API do Kubernetes, e o daemon no Mac lê a mesma API. O passo espera e imprime o log do job.
Passo do KFP (pod) ── cria SiliconJob ──► API do Kubernetes ◄── observa ── kubesilicond (Mac)
      ▲                                                                          │
      └────────────── status + final do log ◄────────────────────────────────────┘
Testei no kind com Kubeflow Pipelines 2.18 em Kubernetes 1.34 e 1.37.
Um pipeline de verdade
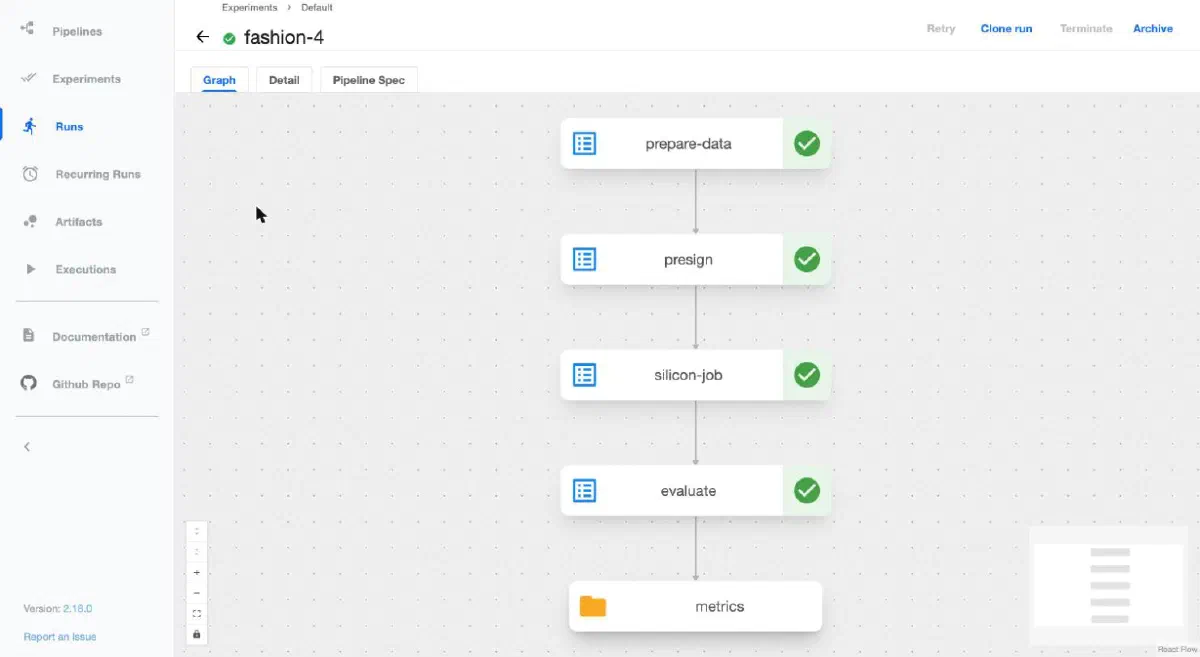
O exemplo treina uma rede pequena no Fashion-MNIST em quatro passos:
- prepare_data (pod) baixa o dataset para o S3 do cluster (SeaweedFS).
- presign (pod) cria URLs pré-assinadas para o Mac ler e escrever só esses objetos.
- silicon_job (GPU do Mac) treina e devolve o modelo por essas URLs.
- evaluate (pod) carrega o modelo na CPU e informa a acurácia.
A execução terminou com device: mps e acurácia de teste de 0,8645. O passo de avaliação, em outra máquina e com outra biblioteca, chegou ao mesmo número que o treino reportou, então os artefatos fizeram a viagem intactos.
Depois registrei o modelo no Kubeflow Hub (o Model Registry) e servi com o KServe. Pedi ao endpoint para classificar 8 imagens de teste e ele acertou as 8. O KServe roda em modo Standard, Deployments simples, sem Knative nem Istio, o que cabe em um kind de 12 GB.
A GPU vale a pena?
Rodei três benchmarks para PyTorch (MPS) e três para MLX: 2 aquecimentos e depois a mediana de 5 execuções, em um M5 Pro com o cluster kind rodando ao mesmo tempo. Dados sintéticos, fp32.
PyTorch (MPS)
| Benchmark | GPU | CPU | Ganho |
|---|---|---|---|
| matmul 1024x1024 | 2,0 ms (1085 GFLOPS) | 1,2 ms (1826 GFLOPS) | 0,6x, a CPU ganha |
| matmul 2048x2048 | 3,4 ms (5081 GFLOPS) | 9,1 ms (1886 GFLOPS) | 2,7x |
| matmul 4096x4096 | 23,6 ms (5830 GFLOPS) | 79,3 ms (1733 GFLOPS) | 3,4x |
| ConvNet passo de treino, batch 64, 3x32x32 | 8,7 ms (7344 img/s) | 67,7 ms (945 img/s) | 7,8x |
| Transformer, 4 camadas, d=512, seq 128, batch 16, fwd+bwd | 41,5 ms (49,4k tok/s) | 182,1 ms (11,2k tok/s) | 4,4x |
MLX
| Benchmark | GPU | CPU | Ganho |
|---|---|---|---|
| matmul 1024x1024 | 1,0 ms (2051 GFLOPS) | 1,1 ms (1916 GFLOPS) | 1,1x |
| matmul 2048x2048 | 1,3 ms (13364 GFLOPS) | 8,5 ms (2016 GFLOPS) | 6,5x |
| matmul 4096x4096 | 8,1 ms (17001 GFLOPS) | 68,4 ms (2009 GFLOPS) | 8,4x |
| MLP passo de treino, batch 512, 784-1024-1024-10 | 1,8 ms (284k samples/s) | 6,7 ms (76k samples/s) | 3,7x |
| Transformer, 4 camadas, d=512, seq 128, batch 16, fwd+bwd | 16,6 ms (123k tok/s) | 149,8 ms (13,7k tok/s) | 9,0x |
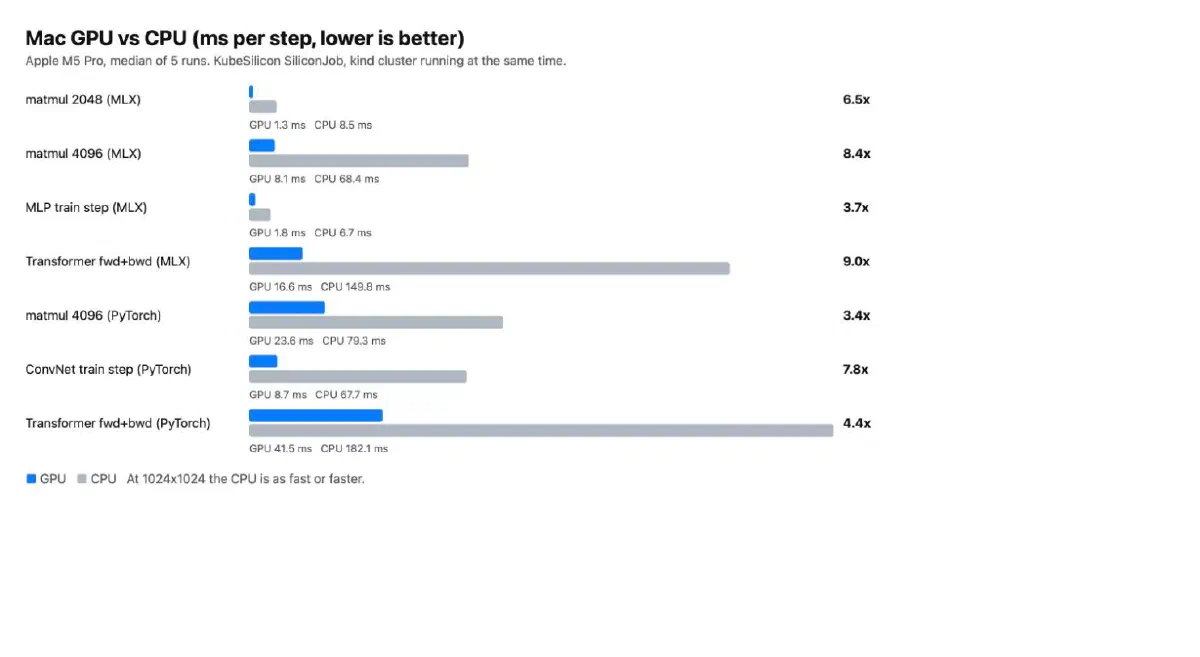
Três coisas que tiro daqui. Primeiro, trabalho pequeno não compensa: em 1024x1024 a CPU é igual ou mais rápida, porque cada chamada à GPU tem custo fixo. Segundo, quando o trabalho é grande o bastante a GPU ganha de 3x a 9x. Terceiro, não leia as linhas de MLX contra PyTorch como “MLX é 3x mais rápido”: os dois transformers não são idênticos, então só as linhas de matmul comparam de igual para igual. O método completo e todos os números estão em docs/benchmarks.md. Não medi: fp16, memória, energia e execuções longas com throttling térmico.
O que eu fiz para sobreviver
Quando funcionou, perguntei o que acontece quando o Mac faz o que Macs fazem.
- Reinício. Um job interrompido é refeito até
backoffLimitvezes (padrão 2) e contado emstatus.attempts. Um script que sai com erro não é refeito. Testei um reinício real: o daemon voltou no login e um job que já tinha terminado não rodou de novo. - Permissões. O daemon pode rodar com um ServiceAccount que só toca nos próprios CRDs e nos Services que ele publica. O
kubectl auth can-iresponde não para secrets, pods e nodes. - Passos travados. O passo do pipeline desiste depois de 15 minutos se o daemon nunca pegar o job, e apaga o objeto pendente.
- Um bug que os testes não pegaram. Depois de um reinício a VM voltava sem rede, porque a placa de rede ganhava um MAC aleatório novo e o cloud-init tinha fixado o primeiro. O MAC agora fica guardado com a VM.
O que ele não é
- Não é uma barreira de segurança. Os jobs rodam dentro do
sandbox-exec(escrita só no diretório do job, sem leitura da sua home), mas a Apple o marcou como deprecado e a rede continua aberta. Não rode código em que você não confia. - Um job de GPU por vez. Os outros esperam como
Pending. Não há limite de memória por job, porque o macOS não tem cgroups. Atualização: a v0.4 roda jobs em paralelo com limite de memória por job, veja o próximo post . - Sem GPU para as VMs. Continua valendo.
- O Katib está deprecado. Eu queria busca de hiperparâmetros, mas a documentação do Kubeflow agora aponta para o
OptimizationJobdo Kubeflow Trainer, que é alpha. Ainda não testei. - Dashboard sem login. O Dashboard do meu lab não tem autenticação nem tema escuro.
Experimente
Ele compila a partir do código-fonte, porque o daemon precisa do entitlement de virtualização:
git clone https://github.com/Matheus-Thurler/KubeSilicon
cd KubeSilicon
make install CTX=kind-<seu-cluster>
kubectl apply -f examples/mlx-matmul.yaml
O exemplo do Kubeflow está em examples/kubeflow/, e o docs/production.md lista o que sobrevive a um reinício e o que não sobrevive. Os releases agora são automáticos: os commits seguem Conventional Commits e o release-please abre o PR de release. O código está em github.com/Matheus-Thurler/KubeSilicon
.
kubectl get related
| NAME | READY | STATUS | AGE |
|---|---|---|---|
 parallel-gpu-jobs-mac-kubesilicon Jobs de GPU em paralelo num Mac só: a memória é o escalonador | 1/1 | Available | <1d |
 kubevirt-on-apple-silicon-kubesilicon KubeVirt não roda em Apple Silicon, então criei o KubeSilicon | 1/1 | Available | 21d |
 virtfoundry-0-13-tenant-isolation Dois tenants, uma bridge: como achamos e corrigimos um vazamento entre tenants no VirtFoundry | 1/1 | Available | <1d |
kubectl get events